Potongan Sintaksis Mengungkap Representasi Sintaksis Inti Angka Multi-digit, Yang Generatif Dan Otomatis Bagian 2
Oct 26, 2023
Pengkodean data
Setiap kata bilangan didefinisikan secara unik oleh kelas leksikal (dalam percobaan ini kami hanya menggunakan satuan, puluhan, atau ratusan) dan nilai 1–9. Misalnya kata ffty merupakan gabungan angka 5 dan kelas Puluhan. Demikian pula, "empat ratus" (mungkin merupakan satu nilai leksikal-fonologis dalam bahasa Ibrani) adalah angka 4 di kelas Ratusan. Sejalan dengan itu, representasi kognitif kata bilangan ada dalam dua morfem, digit, dan kelas (McCloskey et al., 1986), sehingga pengkodean kami didasarkan pada dua morfem tersebut. Kata desimal "seribu" adalah pengecualian: Kami menganggapnya sebagai morfem tunggal, kelas leksikal "seribu" tanpa morfem angka.
Ada hubungan yang tidak dapat dipisahkan antara pengkodean dan memori. Pengkodean mengacu pada mengubah informasi ke dalam format yang dapat diproses oleh otak manusia, sedangkan memori mengacu pada proses menyimpan dan mengambil informasi. Proses pengkodean memiliki dampak penting pada produksi memori, karena proses ini menentukan apakah kita dapat menyimpan informasi dan mengingatnya saat diperlukan.
Secara umum, ingatan manusia dapat dibagi menjadi dua jenis: ingatan jangka pendek dan ingatan jangka panjang. Memori jangka pendek umumnya hanya dapat menyimpan informasi dalam jangka waktu yang lebih pendek, sedangkan memori jangka panjang dapat menyimpan informasi dalam jangka waktu yang lebih lama. Bagi kemampuan memori seseorang, pengkodean merupakan tahapan pertama dan terpenting sebelum penyimpanan memori. Jika ada masalah dengan pengkodean, informasi akan sulit disimpan atau diambil.
Kualitas pengkodean berdampak besar pada memori. Jika kita dapat menggunakan banyak indera untuk pengkodean, seperti penglihatan, pendengaran, penciuman, dll., kita dapat meningkatkan efisiensi pengkodean informasi dan membuat memori lebih kuat. Pada saat yang sama, kita juga perlu menggunakan metode “pemahaman makna” untuk menghubungkan informasi dengan informasi yang sudah ada dalam memori jangka panjang kita, sehingga lebih mudah untuk diingat.
Selain itu, terdapat hubungan antara review dan retrieval antara pengkodean dan memori. Review berarti kembali membaca, mendengarkan, atau melihat informasi kembali setelah disimpan sehingga tetap berada dalam sistem memori dalam jangka waktu yang relatif lebih lama. Ekstraksi mengacu pada pengambilan informasi dan menggunakannya saat dibutuhkan. Jika kita berhati-hati saat melakukan tinjauan pengkodean dan pengambilan secara efektif, kemampuan memori kita akan sangat meningkat.
Dalam hidup, sebagian besar informasi yang kita perlu ingat, termasuk informasi dalam studi, pekerjaan, dan kehidupan sosial. Oleh karena itu, kita perlu melakukan proses pengkodean dengan serius agar informasi dapat disimpan secara efektif di otak kita. Hanya dengan menguasai keterampilan coding yang baik Anda dapat menyimpan, meninjau, dan mengambil informasi dengan lebih baik serta meningkatkan kemampuan memori Anda. Terlihat bahwa kita perlu meningkatkan daya ingat, dan Cistanche deserticola dapat meningkatkan daya ingat secara signifikan, karena Cistanche deserticola juga dapat mengatur keseimbangan neurotransmiter, seperti meningkatkan kadar asetilkolin dan faktor pertumbuhan. Zat-zat ini sangat penting untuk daya ingat dan pembelajaran. Selain itu, Daging juga dapat meningkatkan aliran darah dan meningkatkan pengiriman oksigen, yang dapat memastikan otak menerima nutrisi dan energi yang cukup, sehingga meningkatkan vitalitas dan daya tahan otak..

Klik suplemen tahu untuk meningkatkan daya ingat
Kami mendefinisikan 3 ukuran kinerja untuk setiap percobaan, yang mencerminkan akurasi dalam morfem digit, dalam morfem kelas, atau keduanya. Tingkat akurasi digit didefinisikan sebagai persentase digit stimulus yang muncul dalam respons, terlepas dari urutannya dan mengabaikan digit yang berlebihan. Kata “seribu” tidak termasuk dalam ukuran ini. Tingkat akurasi kelas didefinisikan sebagai persentase kelas leksikal stimulus yang muncul dalam respons, terlepas dari urutannya dan mengabaikan kelas yang berlebihan. Jika stimulus menyertakan kelas leksikal sebanyak dua kali (misal, kelas puluhan dalam "sembilan puluh ribu delapan puluh") namun responsnya hanya menyertakan kelas leksikal satu kali, maka skor akurasinya hanya 1 dari 2. Terakhir, tingkat akurasi morfem ditentukan dengan menggabungkan keduanya. di atas—yaitu, persentase morfem digit dan kelas yang muncul dalam respons peserta, tanpa memandang urutannya. Dalam teks di bawah ini, kami melaporkan tingkat kesalahan morfem, digit, dan kelas, yaitu komplemen hingga 100% tingkat akurasi.
Kemungkinan ukuran keempat adalah tingkat akurasi kata—persentase kata stimulus yang muncul dalam respons. Mirip dengan tingkat akurasi morfem, ukuran ini mempertimbangkan kelas dan digit, tetapi juga memerlukan pemasangan yang benar antara kelas tertentu dengan digit tertentu. Misalnya, mengulang dua puluh tiga as tiga puluh dua akan diberi kode sebagai 0% akurasi kata dan akurasi morfem 100%. Hasil akurasi kata tidak dilaporkan di sini, namun pada dasarnya sama dengan hasil akurasi morfem.
Analisis statistik
Untuk membandingkan dua kondisi, kami memasukkan tingkat kesalahan digit, kelas, atau morfem dari setiap percobaan sebagai variabel terikat dalam model campuran linier (LMM). Partisipan dan Stimulus adalah faktor acak, dan kondisinya adalah faktor dalam-peserta, dalam-stimulus. Dalam beberapa kasus di mana model tidak menyatu, faktor acak Stimulus dipindahkan. Untuk mengontrol fakta bahwa peserta yang berbeda mengulangi rangsangan dengan panjang yang berbeda, Panjang Stimulus (jumlah kata) dimasukkan sebagai kovariat. Kami menggunakan R (R Core Team, 2019) dengan paket lme4 (Bates et al., 2015).
Untuk menentukan apakah pengaruh Kondisi itu signifikan, kami menggunakan uji rasio kemungkinan yang membandingkan LMM dengan LMM yang identik kecuali LMM tersebut tidak menyertakan faktor Kondisi. Untuk perbandingan ini, kami melaporkan statistik pengujian2 (LL1–LL0), yang mengikuti distribusi χ2 (LL0 dan LL1 menunjukkan kemungkinan log dari model tereduksi dan model penuh), dan data yang sesuai nilai p. Derajat kebebasan tidak dilaporkan sebagaimana biasanya: 1. Untuk membandingkan kinerja seorang partisipan di antara dua kondisi, kami menggunakan metode yang sama, namun model tersebut tidak menyertakan faktor Partisipan dan Panjang Stimulus; itu hanya memasukkan Stimulus sebagai faktor acak dan Kondisi sebagai faktor dalam-stimulus. Sebagai ukuran efek, kami melaporkan koefisien faktor Kondisi dalam model. Koefisien ini mendekati selisih antara rata-rata kondisi, sehingga dilambangkan dengan Δ.
Hasil
Empat peserta melakukan tugas versi 7-kata, dan peserta sisanya melakukan tugas6-versi kata.

Prediksi sederhana dari pengelompokan sintaksis adalah jika suatu stimulus memiliki segmen tata bahasa yang lebih banyak atau lebih panjang, maka stimulus tersebut akan lebih mudah diingat. Namun, segmen yang lebih panjang mungkin merugikan jika terlalu panjang; segmen tersebut dapat mengakibatkan terciptanya mega-chunk yang melebihi batas kapasitas memori kerja dan sulit untuk diingat. Dengan demikian, hubungan antara ukuran segmen dan kinerja diharapkan memiliki bentuk U terbalik: Kinerja terbaik seharusnya tidak berada pada rangsangan dengan segmen terpanjang, namun pada rangsangan yang panjang segmennya memberikan keseimbangan optimal antara jumlah bongkahan dan ukuran bongkahan.
Kondisi dengan segmen tata bahasa yang terlalu banyak dan terlalu pendek akan menyebabkan pengelompokan yang relatif sedikit dan menyebabkan strategi memori tidak efektif; dan kondisi dengan segmen yang terlalu sedikit dan terlalu panjang akan mendorong terciptanya potongan yang terlalu besar dan sulit diingat. Seperti ditunjukkan dengan jelas pada Gambar 2, hal inilah yang terjadi: Akurasi tertinggi pada kondisi B dan terendah pada kondisi lainnya. Secara khusus, tingkat kesalahan dalam kondisi B secara signifikan lebih tinggi dibandingkan kondisi C, yang pada gilirannya memiliki lebih banyak kesalahan secara signifikan dibandingkan kondisi D—efek yang jelas dari pengelompokan sintaksis. Yaitu, meskipun para peserta tidak menerima instruksi khusus tentang strategi pengelompokan, mereka masih menggunakan struktur sintaksis angka dan membuat potongan yang mewakili angka-angka gramatikal multi-digit. Seperti yang diharapkan, performa optimal bukan pada kondisi A, yang mana segmen tata bahasanya paling panjang, namun pada kondisi B, yang tampaknya menawarkan keseimbangan optimal antara ukuran bongkahan dan jumlah bongkahan.
Dukungan tambahan untuk gagasan pengelompokan berbasis sintaksis berasal dari analisis posisi spesifik dalam rangsangan di mana kesalahan terjadi. Gambar 3 menunjukkan tingkat kesalahan digit di setiap posisi serial untuk peserta yang mengulangi 6-urutan kata (peserta 7-kata dikeluarkan dari analisis ini untuk menghindari varian terkait panjang). Jika peserta mengingat setiap stimulus sebagai rangkaian kata yang tidak terstruktur, maka tugas tersebut pada dasarnya adalah tugas mengingat bebas. Dalam tugas seperti itu, tingkat kesalahan biasanya harus terendah untuk kata-kata awal dalam daftar dan secara bertahap meningkat untuk kata-kata di bagian bawah daftar (efek primacy), dengan beberapa perbaikan pada kata atau kata terakhir (efek kekinian; Murdock, 1962).
Kondisi D, kondisi terfragmentasi, menunjukkan pola tugas pemanggilan bebas yang tidak terstruktur. Sebaliknya, kondisi A dan B menunjukkan pola yang berbeda, yang menunjukkan bahwa ada faktor tambahan yang berperan di sini selain efek primacy dan recency. Misalnya pada kondisi B tingkat kesalahannya menurun dari kata ke-2 (ribuan) menjadi kata ke-3 (ratusan). Untuk memeriksa pola di setiap kondisi, kami menganalisis keakuratan digit di setiap kata angka dalam 6-angka kata, tidak termasuk kata "seribu" (yang tidak ada digitnya yang dikodekan) dan tidak termasuk kata bukan-seribu terakhir di setiap angka (untuk menghindari efek kekinian).
Kami mengirimkan akurasi digit setiap kondisi secara terpisah ke model campuran linier logistik dengan Partisipan sebagai faktor acak dan posisi serial kata sebagai faktor numerik dalam partisipan. Kami tidak menambahkan Stimulus sebagai faktor acak karena model tersebut mencapai ukuran tunggal dalam beberapa kondisi, namun hasilnya pada dasarnya sama ketika memasukkan faktor ini. Pengaruh Posisi Kata signifikan pada kondisiD (χ2=27.4, hal<0.001) but only barely significant in conditions A (χ2=4.7, p=0.03) and B (χ2=4.2, p=0.04)— unimpressive significance levels that do not withstand a multiple-comparison correction. To show that the difference between conditions was significant, we submitted the data of all conditions together to the same LLMM, now adding the Condition (A/B versus D) and the Condition × Word Position interaction as within-participant factors. The interaction term was significant (χ2=11.5, p<0.001, odds ratio=0.75).
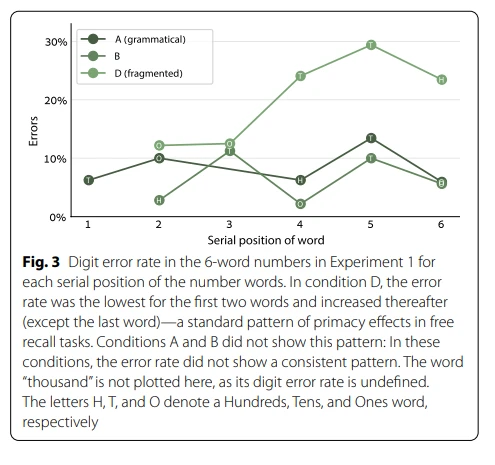
Penarikan serial sederhana tidak dapat menjelaskan hasil pada kondisi A dan B, namun, pengelompokan sintaksis menawarkan penjelasan sederhana untuk pola ini: Pada kondisi D, peserta mengingat setiap stimulus sebagai daftar kata yang tidak terstruktur, namun pada kondisi A dan B mereka cenderung menghafal setiap stimulus. sebagai potongan. Karena tugas chunking ini bukanlah tugas pemanggilan serial yang sederhana, sehingga tidak menunjukkan efek keutamaan dan keterkinian yang standar. Menariknya, dalam kondisi A dan B, efek primacy diamati tidak hanya untuk rangkaian secara keseluruhan: Dalam kedua kondisi tersebut, performa pada kata #4 lebih baik dibandingkan pada suku sebelumnya dan berikutnya, dan kata4–5–6 menunjukkan kebalikannya. Pola berbentuk U. Pola ini sejalan dengan gagasan bahwa kata 4–5–6 dikodekan sebagai bagian yang terpisah, dengan efek keutamaan dan keterkiniannya sendiri pada kata pertama dan terakhir bagian tersebut.
The syntactic chunking pattern—better performance in the more-fragmented conditions, and optimal performance in an interim condition—was observed not only at the group level but even for individual participants. Numerically, each of the participants showed better performance in condition B (optimal chunking) than in condition D (maximum fragmentation) (Fig. 4). This difference was significant for all participants except one (morpheme accuracy rate of each of these participants: paired t(19)>1.73, Bonferroni – Holm mengoreksi satu sisi hal<0.05). Because the different conditions used the same stimuli and manipulated only the word order within each stimulus, we could also compare matched pairs of stimuli and show that a syntactic chunking effect existed even for single stimuli in most cases: Morpheme accuracy was better in condition D than in B only for 6% of the stimuli (and better in B for 63.5%; same in B and D for 30.5%). Nevertheless, the participants also differed from each other—the best-performance condition was different for different participants: For 13 participants, the optimal condition was B, but for 6 participants it was A and for one participant it was C (bottom panels in Fig. 4).

Diskusi
Performa terbaik terjadi pada kondisi B, yang mana setiap stimulus merupakan sepasang segmen 3-kata atau 4-kata. Dalam kondisi C dan D, performanya memburuk karena stimulus memasukkan segmen tata bahasa yang lebih banyak dan lebih pendek. Efek pengelompokan sintaksis ini menunjukkan bahwa peserta membuat representasi struktur sintaksis bilangan bulat, dan representasi ini memungkinkan mereka membuat potongan yang semakin panjang untuk segmen tata bahasa yang semakin panjang.
Performa terbaik bukan pada kondisi A, yang memiliki satu segmen panjang per stimulus, namun pada kondisi B. Yaitu, meskipun performa meningkat dari kondisi D ke C dan dari C ke B, segmen yang lebih panjang (dalam kondisi A) mengganggu penghafalan. Pola hasil ini mendukung gagasan bahwa pengelompokan yang efektif memerlukan keseimbangan optimal antara ukuran bongkahan dan jumlah bongkahan.
Tampaknya dalam kondisi A, peserta menggunakan struktur sintaksis penuh dari 5- atau6-digit angka untuk menyimpan semua kata dalam satu potongan, dan hal ini menyebabkan ukuran potongan yang berlebihan, dan akibatnya hafalan menjadi lebih buruk. Menurut pandangan ini, meskipun tingkat kesalahan memiliki pola berbentuk U, pengelompokan sintaksis yang mendasarinya mempunyai efek yang monoton: Segmen tata bahasa yang lebih panjang selalu menghasilkan bongkahan yang lebih besar, termasuk dalam kondisi A, namun meningkatkan ukuran bongkahan hanya bermanfaat hingga ukuran ambang optimal 3 –4 kata per potongan, yang terjadi pada kondisi B. Selain itu, pada kondisi A, peningkatan potongan akan mengganggu kinerja karena potongan tersebut menjadi terlalu besar untuk ditangani secara efektif oleh peserta—mereka melebihi batas memori kerja yang dikenakan pada setiap potongan Cowan (2001 ). Di bawah, dalam Eksperimen 5, berikan bukti tambahan untuk mendukung kesimpulan ini.

Temuan kami membantah interpretasi alternatif yang mengaitkan perbedaan antara kondisi A dan kondisi B dengan besaran angka. Penafsiran alternatif ini mendalilkan bahwa kinerja dalam kondisi A lebih buruk daripada di B bukan karena alasan yang berkaitan dengan sintaksis dan pemotongan, namun karena angka-angka dalam kondisi A secara numerik lebih besar dan oleh karena itu lebih sulit untuk diproses (efek samping). Dua aspek dari data kami membantah penafsiran alternatif: Pertama, data tersebut tidak dapat menjelaskan pola kesalahan per posisi pada Gambar 3. Kedua, penafsiran alternatif memperkirakan bahwa bilangan 5- atau 6- 6-digit (seperti pada kondisiA ) akan selalu lebih sulit untuk dihafal dibandingkan sepasang angka yang lebih pendek (kondisi B), terlepas dari angka spesifiknya. Seperti yang akan kita lihat pada Eksperimen 5, prediksi ini terbantahkan.
Kinerja unggul dalam kondisi B dibandingkan dengan kondisi A menghasilkan beberapa kesimpulan penting. Pertama, ini menunjukkan cakupan representasi sintaksis angka—khususnya, representasi sintaksis lintas triplet. Pada kondisi B, C, dan D, tidak ada segmen tata bahasa yang melewati batas triplet tunggal (ratusan+puluhan+satu). Perbedaan antara kondisi-kondisi ini dapat dijelaskan sebagai representasi sintaksis dalam triplet—misalnya, representasi yang memanfaatkan fakta bahwa tiga kata dalam setiap triplet mempunyai kelas leksikal yang berbeda. Situasinya berbeda dalam kondisi A versus B: Satu-satunya perbedaan antara kedua kondisi ini adalah bahwa kondisi A, bukan B, menggabungkan kata-kata dari dua kembar tiga menjadi satu segmen. Perbedaan yang signifikan antara kedua kondisi tersebut menunjukkan bahwa dalam kondisi A, tetapi tidak dalam kondisi B, peserta membuat representasi sintaksis lintas triplet. Dalam Diskusi Umum, kita kembali ke implikasi pendanaan ini.
Kesimpulan kedua menyangkut otomatisitas. Pada kondisi A, representasi sintaksis lintas triplet tercipta meskipun tidak bermanfaat—mengganggu kinerja. Hal ini sangat menunjukkan bahwa penciptaan representasi sintaksis tidak dihasilkan dari keputusan strategis yang disengaja dan disengaja, namun merupakan proses otomatis.
Kesimpulan ketiga berkaitan dengan apakah representasi sintaksis diambil sebagai template yang kaku atau dibuat secara dinamis melalui proses generatif. Cowan (2001) mengusulkan bahwa setidaknya ada dua metode berbeda dalam membuat bongkahan, dan kedua metode ini berbeda dalam batasan yang diterapkan pada ukuran bongkahan. Salah satu caranya adalah dengan mengambil templat yang telah diingat, yang berfungsi sebagai dasar potongan, dan menyematkan beberapa item dalam templat ini (setiap item merupakan representasi dari memori jangka panjang). Misalnya, ini mungkin cara pemain catur ahli mengkodekan gerakan kompleks. Jumlah item dalam templat tersebut kadang-kadang mungkin cukup besar—lebih dari kapasitas memori jangka pendek standar yang berjumlah 3–4 item—namun templat tersebut tetap berupa satu kesatuan. Metode kedua untuk membuat potongan adalah dengan membentuk asosiasi ad hoc baru antar item. Metode ini lebih dinamis dan fleksibel, namun biayanya adalah ukuran potongan tunduk pada batas kapasitas memori kerja sebesar 3-4 item. Hal yang penting adalah bahwa kedua metode ini berbeda dalam batasan yang diterapkan pada ukuran potongan: Metode terakhir tunduk pada batasan kapasitas memori kerja, sedangkan metode pertama tidak. Jadi, dalam percobaan kami, jika potongan sintaksis dibuat dengan cara generatif, maka potongan tersebut harus tunduk pada batas kapasitas memori kerja, yang menyebabkan kinerja buruk dalam potongan yang terlalu besar—pola persis seperti yang kita lihat dalam kondisi A. Seandainya struktur sintaksis angka tersebut telah dihafalkan template, peserta bisa saja membuat potongan berbasis template, yang tidak tunduk pada batasan kapasitas, dan kinerja pada kondisi A (dengan 1 potongan per stimulus) seharusnya lebih baik dibandingkan kondisi B (2 potongan per stimulus). kasus. Oleh karena itu kami menyimpulkan bahwa struktur sintaksis nomor tersebut tidak diambil sebagai templat hafalan yang telah ditentukan sebelumnya, namun dibuat melalui proses ageneratif secara real time.
Pengelompokan sintaksis benar-benar menunjukkan representasi sintaksis
Pengelompokan yang efisien melibatkan dua aspek utama dari stimulus: keterdeteksian dan kompresibilitas (Chekaf et al., 2016). Aspek pertama berkaitan dengan deteksi keteraturan dalam stimulus, yang memberikan peluang untuk penggalangan yang efektif, misalnya dengan menetapkan batas-batas potongan yang optimal. Dalam kasus kami, ini mengacu pada deteksi segmen tata bahasa. Aspek kedua mengacu pada proses yang mengompresi data menjadi sebuah potongan, mungkin dengan mengandalkan beberapa representasi dengan asosiasi yang kuat antara elemen-elemen potongan tersebut (Cowan, 2001). Dalam kasus kami, kompresibilitas mungkin didorong oleh representasi sintaksis angka tersebut.
Kami menafsirkan hasil Eksperimen 1 dalam hal kompresibilitas: Kami berpendapat bahwa perbedaan penting antara kondisi eksperimen adalah bahwa kondisi tersebut memengaruhi kemampuan peserta untuk membuat potongan berbasis sintaksis. Namun, mungkinkah kondisinya berbeda satu sama lain dalam kemampuan mendeteksi segmen tata bahasa? Dalam Eksperimen 1, kami sengaja tidak memberikan petunjuk apa pun untuk pengelompokan (agar tidak memberikan petunjuk apa pun yang dapat memengaruhi kemampuan deteksi), namun jika tidak ada petunjuk tersebut, peserta mungkin akan menggunakan strategi lain yang dapat menimbulkan tingkat deteksi berbeda dalam kondisi apa pun. . Misalnya, mereka mungkin menggunakan strategi sederhana seperti "menutup potongan" setelah setiap kata—sebuah strategi yang mungkin menghasilkan pengelompokan yang lebih efisien di kondisi B dibandingkan di kondisi D. Alternatifnya, mereka mungkin menggunakan strategi terbuka berdasarkan pengetahuan matematika formal mereka, dan strategi seperti itu mungkin lebih mudah diterapkan dalam kondisi tata bahasa, yang mungkin lebih sesuai dengan pengetahuan formal peserta tentang angka. Efek dari kemampuan deteksi mungkin semakin diperkuat dengan desain blok pada Eksperimen 1, yang memungkinkan pengembangan strategi kondisi spesifik di setiap blok.
Perbandingan antara kondisi A dan B dalam Eksperimen 1 menunjukkan bahwa hal ini tidak terjadi, karena peserta menciptakan representasi sintaksis bahkan ketika hal ini tidak membuahkan hasil (dalam kondisi A). Namun demikian, kami merancang Eksperimen 2 dan 3 untuk secara khusus menyangkal penafsiran alternatif. Dalam Eksperimen 2, kami menggunakan desain campuran untuk mencegah strategi blok tertentu. Dalam Eksperimen 3, kami memberikan petunjuk yang jelas tentang batasan bagian, untuk meminimalkan perbedaan deteksi antar kondisi.
Eksperimen 2: desain campuran
Desainnya mirip dengan Eksperimen 1, namun di sini kondisi yang berbeda dicampur dalam satu blok. Desain ini akan menyulitkan penggunaan strategi terbuka karena peserta tidak dapat mengetahui struktur sintaksis dari stimulus tertentu sampai stimulus tersebut dimainkan. Dengan demikian, efek pengelompokan sintaksis dalam Eksperimen 2 akan sulit dijelaskan sebagai akibat dari strategi yang berlebihan.

metode
Terdapat 3 kondisi dengan 2, 3, atau 4 segmen tata bahasa per stimulus, dengan masing-masing 4, 9, dan 7 percobaan di setiap kondisi. Semua jenis uji coba disajikan dalam satu blok, dalam urutan acak (urutan yang sama untuk semua peserta). Para pesertanya adalah orang-orang yang sama yang melakukan Eksperimen 1; mereka melakukan Eksperimen 2 segera sebelum atau sesudah Eksperimen 1 (lihat bagian "Tugas pengelompokan sintaksis"). Setiap peserta melakukan tugas versi 6-kata atau 7-kata, seperti pada Eksperimen 1. Pengkodean data dan analisis statistik sama seperti pada Eksperimen 1, namun dalam model campuran linier, faktor Kondisi adalah faktor numerik antar-stimulus daripada faktor kategoris dalam-stimulus. (Itu masih dalam peserta.)

hasil dan Diskusi
Hasil Eksperimen 1 pada dasarnya direplikasi: Performa Te lebih baik pada kondisi dengan segmen yang lebih sedikit dan lebih panjang (Gbr. 5). Model campuran linier menunjukkan bahwa efek Kondisi signifikan terhadap tingkat kesalahan morfem (Δ=2.2%, χ2=4.17, p=0.04) dan tingkat kesalahan kelas (Δ =2.5%, χ2=5.09, p=0.02), meskipun tidak untuk tingkat kesalahan digit (Δ=1.9%, χ{{16} }.48, hal=0.12).
Hasil ini sulit untuk dijelaskan sebagai sebuah strategi terbuka. Agar strategi terbuka tersebut efektif, para peserta harus menentukan strategi mereka pada setiap percobaan dan melakukannya hanya setelah stimulus dimainkan, pada saat tantangan menghafal sudah dimulai. . Penjelasan yang lebih baik dan lebih masuk akal adalah bahwa kondisi tata bahasa lebih menguntungkan karena adanya pengelompokan sintaksis.
Eksperimen 3: memberi isyarat secara terbuka
Eksperimen ini secara khusus bertujuan untuk mengesampingkan keterdeteksian segmen gramatikal sebagai penjelasan efek pengelompokan sintaksis. Untuk mencapai tujuan ini, kami mengubah kemampuan deteksi menjadi hal yang tidak menjadi masalah dengan membuatnya semudah mungkin dalam segala kondisi: Kami memberikan peserta petunjuk yang jelas dan eksplisit tentang bagaimana mereka harus membagi rangkaian kata menjadi beberapa bagian. Jika perbedaan antara kondisi dalam Eksperimen 1 berasal dari keterdeteksian segmen tata bahasa, isyarat yang jelas harus mengesampingkan perbedaan spesifik stimulus yang halus, dan kinerjanya harus serupa di seluruh kondisi. Namun, jika hasil Eksperimen 1 dihasilkan dari kompresibilitas segmen tata bahasa yang lebih tinggi, hasilnya juga harus direplikasi di sini.
metode
Pesertanya adalah 20 orang dewasa berusia 19;6–52;7(rata-rata=27;7, SD=7;9). Eksperimen ini hanya mencakup dua kondisi, identik (rangsangan yang sama) dengan kondisi Eksperimen 1 B (tata bahasa) dan D (terfragmentasi). Semua peserta melakukan tugas versi 7-kata. Kondisi tersebut dikelola sebagai dua blok dalam tatanan yang berlawanan. Prosedurnya sama seperti pada Eksperimen 1, hanya saja sekarang kami memberikan petunjuk yang jelas untuk batas-batas bongkahan. Secara kritis, isyarat tersebut identik dalam kedua kondisi (tata bahasa dan terfragmentasi): Dalam kedua kasus, peserta diberi isyarat untuk membagi setiap stimulus menjadi dua bagian, satu dengan 3 kata dan satu lagi dengan 4 kata. Dalam kondisi tata bahasa, isyarat membagi stimulus menjadi { {14}}digit angka dimulai dengan digit 1, diikuti dengan 3-digit angka (misalnya seribu dua ratus tiga puluh empat; lima ratus enam puluh lima). Dalam kondisi terfragmentasi, isyarat membagi stimulus menjadi dua bagian dengan panjang yang sama, namun tidak ada bagian yang gramatikal: Urutan kata dibalik untuk menghindari pasangan kata yang valid secara gramatikal (lima enam puluh ratus; empat tiga puluh ratus ribu).
Sebagai isyarat, kami menggunakan dua aspek intonasi. Pertama, pelaku eksperimen tidak mengucapkan sejumlah kata dengan kecepatan tetap seperti pada Eksperimen 1, namun seperti yang kita katakan dalam dua angka: Tidak ada penundaan antara kata-kata dalam setiap bagian stimulus dan penundaan sekitar 1 detik antara dua bagian stimulus. Kedua, kata terakhir setiap bagian stimulus diucapkan dengan nada menurun (intonasi khas kata-kata terakhir dalam kalimat), dan semua kata sebelumnya diucapkan dengan intonasi yang gemuk. Untuk memfasilitasi perhatian terhadap isyarat ini, rangsangan tidak diputar dari rekaman seperti pada Eksperimen 1 tetapi diucapkan secara real-time oleh pelaku eksperimen. Pengkodean data dan analisis statistik berada pada Eksperimen 1.
hasil dan Diskusi
Hasil Eksperimen 1 pada dasarnya direplikasi: Tingkat kesalahan morfem Te, tingkat kesalahan digit, dan tingkat kesalahan kelas lebih rendah pada kondisi tata bahasa dibandingkan pada kondisi terfragmentasi (Gbr. 6a; dengan LMM yang dijelaskan dalam Eksperimen 1 bagian "Analisis statistik", morfem: Δ=12.3%, χ2=140.5, hal<0.001; digits: Δ=12.1%, χ2=136.1, p<0.001; classes: Δ=10.8%, χ2=103.8, p<0.001). Even at the single-subject level, the morpheme error rate was lower in the grammatical condition than in the fragmented condition for every single participant (Additional file 1: Fig. S2).
Perbedaan antara kedua kondisi tersebut, yang ada meskipun kami memberikan petunjuk yang sangat jelas tentang cara membagi setiap stimulus menjadi dua bagian, tidak mungkin muncul dari tingkat keterdeteksian segmen gramatikal yang berbeda dalam kedua kondisi tersebut. Interpretasi yang paling mungkin dari hasil ini adalah bahwa kondisi tata bahasa, dengan menggunakan sintaksis bilangan yang valid, memungkinkan kompresibilitas yang lebih tinggi dari rangkaian kata bilangan.
Eksperimen 4: representasi sintaksis dapat menangani berbagai struktur tidak beraturan
Eksperimen 1–3 menunjukkan bahwa peserta mewakili struktur sintaksis angka dan menggunakannya sebagai dasar untuk pengelompokan. Eksperimen 4 menguji dua aspek tambahan dari representasi sintaksis ini: cakupannya, yaitu struktur sintaksis spesifik yang dapat direpresentasikan, dan fleksibilitasnya, yaitu kemampuan untuk dengan cepat beralih dari satu struktur sintaksis ke struktur sintaksis lainnya. Untuk tujuan ini, kami menyertakan angka dengan beberapa struktur sintaksis berbeda.
Cakupan. Eksperimen 1–3 menggunakan cakupan angka yang terbatas: Semua rangsangan didasarkan pada angka yang tidak menyertakan 0 atau 1. Desain ini bertujuan untuk menghindari kerumitan yang mungkin timbul dari angka dengan 0 dan 1, karena dua digit ini membuat angka verbal dengan struktur sintaksis tak beraturan: Dalam bahasa Ibrani, mirip dengan bahasa Inggris, angka 0 tidak diwujudkan secara lisan, dan angka 1 pada posisi dekade diwujudkan secara lisan sebagai kata remaja dan bukan kata puluhan standar. Dengan menghindari 0 dan 1, Eksperimen 1–3 hanya menyertakan angka dengan struktur sintaksis beraturan dan tidak ada angka dengan struktur tidak beraturan. Sebaliknya, Eksperimen 4 menguji apakah representasi sintaksis juga akan dibuat untuk bilangan tak beraturan.

Fleksibilitas. Aspek kedua yang kami periksa adalah fleksibilitas mekanisme sintaksis. Dalam Percobaan 1 dan 3, semua angka dalam blok tertentu mempunyai struktur sintaksis yang sama. Eksperimen 2 memiliki desain campuran, tetapi hanya menggunakan sedikit variasi struktur sintaksis. Eksperimen 4 menggunakan lebih banyak struktur sintaksis dan menyajikannya dalam urutan acak, sehingga kita dapat menguji apakah representasi sintaksis dan proses yang menciptakannya cukup fleksibel untuk dijadikan dasar bagi pemotongan sintaksis bahkan dalam skenario yang lebih menuntut ini.
For more information:1950477648nn@gmail.com