Pengenalan Bahasa Isyarat Spatio-Temporal Berkelanjutan Menggunakan Jaringan Multi-Fitur Penuh Perhatian(2)
Jun 01, 2023
3.5. Pembelajaran Urutan
Sequence Learning Setelah mendapatkan hasil dari ekstraktor fitur spasial dan temporal berupa gloss feature, kita perlu menyusunnya menjadi kalimat lengkap. Oleh karena itu, kita perlu menggunakan sequence learning untuk memastikan bahwa gloss berhasil membentuk kalimat yang baik. Metode yang paling umum dalam penelitian saat ini mengacu pada Bidirectional Long Short Term Memory (Bi-LSTM) dan Connectionist temporal classification (CTC) [17,23] untuk masalah yang dapat diselesaikan menggunakan CTC dan beberapa karya terbaru [17,23] mengusulkan CTC sebagai proses pelatihan end-to-end untuk CSLR.

bubuk ekstrak Cistanche
Klik di sini untuk melihat produk-produk Cistanche
【Minta lebih lanjut】 Email:cindy.xue@wecistanche.com / Whats App: 0086 18599088692 / Wechat: 18599088692
Memori jangka pendek panjang (LSTM) [44] adalah varian dari jaringan saraf berulang (RNN), dan banyak digunakan dalam pemodelan urutan. LSTM dengan sangat baik memodelkan ketergantungan jangka panjang; itu dapat memproses seluruh urutan input dan menggunakan keadaan internalnya untuk memodelkan transisi keadaan. Namun, kekurangan dari forward RNN ini adalah status tersembunyi hanya dipelajari dari arah satu arah. RNN menghasilkan status tersembunyi seperti yang dijelaskan oleh persamaan di bawah ini setelah menerima urutan fitur sebagai input.
ht=RNN(ht−1,ot),
di mana ht menyatakan keadaan tersembunyi, di mana keadaan awal h0 adalah vektor nol tetap, dan t adalah langkah waktu. RNN digunakan untuk memprediksi glos tanda sesuai dengan input urutan fitur spasial.
Apalagi tugas SL cukup kompleks. Oleh karena itu, tidak hanya membutuhkan fitur yang diterima dari konteks satu arah tetapi juga membutuhkan bantuan dengan penggunaan informasi dua arah untuk mempelajari kemunculan kata yang datang sebelum dan sesudah kata lain dalam kalimat. Akibatnya, kami menggunakan Bi-LSTM [45] untuk mempelajari ketergantungan dinamis yang kompleks dari urutan gambar dengan mengubahnya menggunakan representasi spasial dan temporal menjadi urutan fitur gloss. Berdasarkan penjelasan sebelumnya, metode Bi-LSTM dapat melakukan pekerjaan dua arah dengan metode LSTM. Artinya metode Bi-LSTM dapat mengklasifikasikan data sekuensial dengan lebih baik. Komputasi Bi-LSTM yang menggunakan keadaan tersembunyi dua arah juga dapat dilihat sebagai komputasi berulang dari LSTM yang diproses dari depan ke belakang dan kemudian dari belakang ke depan. Selanjutnya, hidden state dari setiap time step dilewatkan melalui fully connected layer dan softmax layer [17].
bubuk cistanche
pada=W(ht ditambah b),
yt,j=e at,j ∑ke at,j ,
di mana b adalah vektor bias dan y(t,j) mewakili probabilitas label j pada langkah waktu t. Dalam tugas TSL kita, label j adalah kosakata yang diperoleh dari kalimat tersebut. Dalam praktiknya, Bi-LSTM secara signifikan meningkatkan jumlah informasi yang dapat diakses jaringan, yang pada gilirannya meningkatkan konteks informasi yang tersedia dalam algoritme. Informasi berisi pengetahuan tentang kata mana yang muncul setelah atau sebelum frame saat ini dalam masukan urutan fitur kalimat.
Bi-LSTM mengirimkan status tersembunyi sebagai output ke lapisan CTC untuk setiap langkah waktu. Karena hasil Bi-LSTM ini tidak memperhatikan susunan kilap, kami menggunakan CTC untuk menangani video sequence mapping o={ot} T 0 t=1 untuk menghasilkan tanda urutan gloss `={` i} IL =1 (L Kurang dari atau sama dengan T) dengan susunan yang lebih baik. CTC digunakan di banyak bidang, termasuk pengenalan tulisan tangan [46], pengenalan ucapan [47], dan pengenalan bahasa isyarat [17,23]. Dalam domain ini digunakan sebagai fungsi penilaian tanpa menyelaraskan urutan input dan output. Dalam CSLR, CTC dikenal sebagai modul yang dikembangkan untuk tugas end-to-end yang melibatkan klasifikasi data temporal tanpa segmentasi. Melalui pemrograman dinamis, CSLR dapat mengatasi masalah penyelarasan dengan membuat label kosong (-) yang memungkinkan sistem menghasilkan hasil yang optimal untuk representasi data yang tidak memiliki label (seperti data epentesis dan segmen data non-gestur). Secara khusus, CTC menghasilkan label kosong "-" untuk memperluas kosakata V, dengan V=Vorigin ∪ {-}. Label kosong ini bertujuan untuk merepresentasikan transisi dan memberitahukan adanya blank gloss yang tidak memberikan informasi untuk proses pembelajaran, seperti π={πt} T 0 t{{20 }}, dimana πt ∈ V. Hasilnya, CTC dapat mengelola parameter output dari ekstraktor fitur spasial dan temporal dan juga Bi-LSTM sebagai modul penyelarasan dengan meringkas probabilitas semua jalur yang memungkinkan. Semua jalur penjajaran π memiliki probabilitas yang diberikan urutan input sebagai berikut [17]:

Eksperimen Cistanche deserticola
p(π| o) {{0}} T 0 ∏ t=1 p(πt|o)=T 0 ∏ t=1 yt, πt
Pada langkah selanjutnya, kita mendefinisikan operasi pemetaan banyak-ke-satu B, yang menghilangkan ruang kosong dan menduplikat kata dari jalur perataan. Misalnya, B (II-am- -a- -doctor)=I, am, a, doctor. Sebagai hasilnya, kita dapat menghitung probabilitas bersyarat urutan gloss tanda l sebagai total probabilitas semua rute yang dapat dipetakan ke l dari B, dengan cara yang dijelaskan di bawah ini [17]:
p(π|o) = ∑ π∈B−1 p(π|o)
di mana B −1 (l)={π|B(π)=l} adalah operasi invers dari B. Terakhir, hilangnya CTC dari urutan fitur didefinisikan sebagai berikut [17]:
Lctc=− ln p(` |o)
Probabilitas bersyarat p(π|X) dapat dihitung berdasarkan asumsi independensi bersyarat.
4. Hasil Eksperimen dan Pembahasan

Suplemen Cistanche dekat saya-Meningkatkan Memori
Pada bagian ini, kami akan menjelaskan detail percobaan kami dengan konfigurasi yang diusulkan seperti yang dijelaskan pada bagian sebelumnya.
4.1. Dataset
Pada bagian ini, kami menjelaskan kumpulan data yang kami gunakan selama eksperimen ini. Kami menggunakan dua dataset, pertama adalah dataset CSL [8,40,41] dan yang kedua adalah dataset RWTH-PHOENIX [33,39]. Kedua dataset ini merupakan dataset bahasa isyarat yang berkesinambungan, yang digunakan untuk menerjemahkan beberapa rangkaian gestur menjadi kalimat utuh.
4.1.1. Kumpulan Data CSL
Dataset CSL telah digunakan oleh beberapa karya [8,40,41]. Ada total 100 kalimat dan 178 kata yang ada dalam kumpulan data ini, yang biasa digunakan dalam komunikasi sehari-hari. Dataset ini berisi rata-rata 5 kata per kalimat. Setiap kalimat dilakukan oleh 50 penandatangan sebanyak 5 kali. Jadi, jumlah total video adalah 25,000, menjadikannya salah satu kumpulan data terbesar. Untuk melatih model CSL, kami membagi set data menjadi data untuk pelatihan dengan 20,000 video dan untuk pengujian dengan 5000 video dari kalimat yang sama tetapi dengan penanda yang berbeda.
4.1.2. Kumpulan Data RWTH-PHOENIX
Dataset RWTH-PHOENIX [33,39] adalah dataset bahasa isyarat Jerman, yang merupakan rekaman siaran cuaca publik dari stasiun televisi di Jerman. Video ini diolah sehingga memiliki ukuran 210×260. Terdapat 6841 kalimat berbeda yang ditandatangani oleh 9 penanda tangan berbeda. Semua penandatangan mengenakan pakaian berwarna gelap dengan latar belakang berwarna terang. Secara total, ada 1232 kata dengan sekitar 80,000 glos. Dataset ini dibagi sesuai format yang telah ditentukan, terdiri dari 5672 sampel pelatihan, 540 sampel validasi/dev, dan 629 sampel uji.
4.2. Pra-pemrosesan Data
Hal pertama yang perlu kami lakukan adalah memproses dataset kami agar sesuai dengan model yang kami usulkan. Kami melakukan pengubahan ukuran dan pemotongan, seperti yang diilustrasikan oleh Gambar 3; di sisi kiri, kita bisa melihat bahwa data aslinya berukuran full HD atau resolusi 1920×1080. Kami perlu memangkas dan mengubah ukurannya menjadi resolusi 224 × 224 karena modul spasial kami menerima input dengan ukuran yang sama dengan input ResNet50. Setelah itu, kami memasukkan data ke dalam model spasial kami, yang akan menghasilkan tensor 7 × 7 dari satu gambar.
Gambar full-frame yang diproses sebelumnya kemudian digunakan untuk menghasilkan fitur titik kunci. Kami menggunakan model HRNet untuk memprediksi 133 poin kunci dari gambar RGB ini. Namun, kami hanya menggunakan 27 titik kunci tubuh bagian atas dalam model yang kami usulkan. Ukuran masukan untuk fitur titik kunci adalah 27 × 3 karena kita memiliki data koordinat 3-sumbu (x, y, dan z) per titik. Dimensi input model adalah N × 224 × 224 × 3 untuk fitur full-frame dan N × 1 × 27 × 3 untuk input keypoint, dengan N adalah jumlah frame. Untuk meningkatkan variasi dataset, kami mengikuti augmentasi dari [12], termasuk pemangkasan acak, pembalikan horizontal, dan penskalaan temporal acak. Pemangkasan acak juga digunakan sebagai bagian dari langkah prapemrosesan untuk memangkas gambar asli.

Suplemen Cistanche dekat saya-Meningkatkan Memori
4.3. Metrik Evaluasi
Untuk mengevaluasi kinerja pengenalan model yang kami usulkan, kami menggunakan metrik tingkat kesalahan kata (WER), yang merupakan metrik yang biasa digunakan dalam CSLR untuk memperkirakan akurasi pengenalan kalimat yang diprediksi, seperti yang ditunjukkan oleh persamaan di bawah ini [17]:
WER=S ditambah I ditambah DT=S ditambah I ditambah DS ditambah C ditambah D
di mana S adalah jumlah substitusi dari kata aslinya, I adalah jumlah penyisipan yang tidak ada di kalimat aslinya, D adalah jumlah penghapusan yang seharusnya ada di kalimat aslinya, C adalah jumlah kata yang benar yang cocok kalimat asal, dan T adalah jumlah kata dalam kalimat tersebut atau yang dapat diperoleh dari penjumlahan kata ganti, hapus, dan benar. Untuk CSL, setiap karakter digunakan untuk mewakili sebuah kata.
4.4. Eksperimen pada Aliran Input
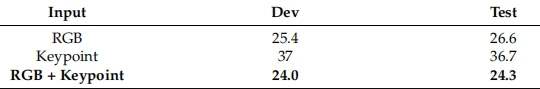
Eksperimen ini terutama berfokus pada membandingkan input aliran tunggal dan multi aliran pada model kami. Tujuannya adalah untuk menemukan konfigurasi terbaik dari input stream. Kami hanya menggunakan kumpulan data RWTH-PHOENIX dalam eksperimen ini. Model kami akan menerima dua input terpisah, input full-frame dan keypoint. Input single-stream hanya menggunakan fitur RGB dari gambar full-frame. Ada dua eksperimen input aliran tunggal. Yang pertama hanya menggunakan fitur full-frame dari gambar RGB, dan yang kedua menggunakan fitur keypoint dari input keypoint. Input multi-aliran yang kami usulkan terdiri dari fitur RGB dan keypoint. Hasil perbandingan menggunakan single stream dan multi stream ditunjukkan pada Tabel 1. Di sini dapat dilihat bahwa dengan menggunakan fitur multi stream dapat diperoleh hasil yang lebih baik dibandingkan dengan menggunakan single stream. Arus utama diperoleh dari fitur RGB full-frame dan aliran tambahan menggunakan fitur keypoint. Aliran keypoint tambahan membantu model untuk belajar lebih baik, terutama untuk menangkap detail bentuk tangan.
Tabel 1. Perbandingan Kinerja WER menggunakan single stream dan input multi-stream.
4.5. Eksperimen pada Modul Perhatian
Tujuan dari percobaan ini adalah untuk memilih konfigurasi terbaik dari modul perhatian. Dalam eksperimen ini, kami menggunakan konfigurasi hasil terbaik dari hasil eksperimen sebelumnya dan dataset yang sama. Kami menunjukkan perhatian spasial sebagai model dengan lapisan perhatian diri di akhir modul spasial untuk setiap fitur. Perhatian temporal awal adalah lapisan perhatian diri setelah pengumpulan temporal pertama, dan perhatian temporal akhir adalah lapisan perhatian diri setelah pengumpulan temporal kedua. Di sini, kita akan membandingkan semua konfigurasi di atas dan kombinasi perhatian spasial dan temporal. Hasilnya ditunjukkan pada Tabel 2. Hasil perhatian spasial lebih buruk daripada perhatian sementara. Tingkat spasial berisi urutan fitur untuk setiap frame. Seperti disebutkan dalam [20], lapisan perhatian diri lebih mudah untuk mempelajari jalur yang lebih pendek antara dependensi yang panjang. Oleh karena itu, spatial attention gagal menurunkan WER karena sequence yang panjang. Di sisi lain, kami bisa mendapatkan hasil yang lebih baik menggunakan perhatian sementara dengan meletakkannya setelah penyatuan sehingga akan mendapatkan panjang urutan yang lebih pendek. Perhatian terlambat yang memiliki panjang urutan terpendek memperoleh hasil terbaik. Selain itu, kombinasi modul atensi secara spasial dan temporal lebih buruk daripada hanya menggunakan atensi tunggal. Berdasarkan hasil ini, kami menerapkan konfigurasi terbaik untuk eksperimen selanjutnya.
Tabel 2. Perbandingan Kinerja WER menggunakan konfigurasi perhatian yang berbeda

4.6. Eksperimen Ablasi di Jaringan STAMF
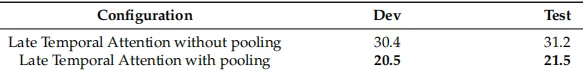
Selanjutnya, kami melakukan eksperimen ablasi menggunakan dataset yang sama dan konfigurasi terbaik dari input stream dan modul perhatian. Tabel 3 pada eksperimen yang menggunakan late temporal attention tanpa pooling membuktikan bahwa panjang sequence mempengaruhi kinerja attention. Eksperimen yang menggunakan lapisan penyatuan dengan panjang urutan yang lebih pendek mendapatkan hasil yang lebih baik. Kami juga melakukan percobaan ablasi untuk mengetahui kinerja menggunakan model yang berbeda untuk pembelajaran sekuens. Hasil pada Tabel 4 menunjukkan bahwa penggunaan LSTM yang hanya memiliki informasi satu arah memiliki kinerja yang lebih rendah dibandingkan dengan Bi-LSTM yang memiliki informasi dua arah.
Tabel 3. Perbandingan Kinerja WER menggunakan konfigurasi perhatian temporal akhir yang berbeda.
Tabel 4. Perbandingan Kinerja WER menggunakan konfigurasi pembelajaran urutan yang berbeda.

4.7. Eksperimen di Jaringan STAMF
Pada bagian ini, kami menjelaskan proses pelatihan lengkap untuk model yang kami usulkan yang disebut multi-fitur spatiotemporal penuh perhatian (STAMF). Ini akan mencakup bagaimana kami memasukkan data input kami ke dalam modul spasial, modul temporal, dan modul pembelajaran urutan langkah demi langkah. Di bagian ini, kami menggunakan input multi-aliran dan konfigurasi perhatian temporal akhir.
4.7.1. Detail Implementasi
Kami melakukan pelatihan dan pengujian end-to-end menggunakan bingkai input dengan ukuran 224 × 224. Untuk pengoptimal, kami menggunakan pengoptimal Adam dengan 10−4 sebagai kecepatan pembelajaran dan membaginya dengan 2 pada zaman 10 dan 15 untuk CSL dan zaman 30, 40, dan 60 untuk RWTH PHOENIX. Kami menetapkan ukuran batch ke 4 dan melakukan 80 epoch untuk RWTH-PHOENIX dan 20 epoch untuk CSL. Pelatihan dan pengujian dijalankan pada NVIDIA Tesla V100 dan RAM 128G.
Pada awalnya, kami mengekstrak fitur dari aliran RGB menggunakan ResNet50 dan menggunakan HRNet untuk mendapatkan titik kunci, lalu mengekstrak fitur titik kunci menggunakan ResNet50. Perhatikan bahwa kami berurusan dengan data berurutan atau video. Karenanya, kami perlu mengonfigurasi ukuran input kami tergantung pada panjang video. Untuk alasan teknis, ukuran input untuk semua data harus identik satu sama lain. Oleh karena itu, kita harus mengetahui video terpanjang dalam dataset kita, kemudian kita menambahkan panjang frame input kita agar sesuai dengan nomor frame terbesar
Fitur-fitur yang diekstraksi secara berurutan ini digunakan oleh modul temporal. Setiap aliran berurutan melewati dua kumpulan temporal yang ditumpuk. Setiap kumpulan temporal terdiri dari jaringan konvolusional 1-dimensi dan lapisan kumpulan maksimum, yang mengurangi setengah panjang urutan. Output dari temporal pooling dari kedua aliran kemudian dihubungkan ke lapisan perhatian dan untuk temporal pooling terakhir, setelah lapisan perhatian, itu digabungkan di bagian akhir sebagai keluaran modul temporal.
Output temporal diproses oleh modul sequence learning. Prosesnya menggunakan lapisan Bi-LSTM yang terhubung dengan CTC untuk mendapatkan penyelarasan akhir dan menyusun gloss menjadi kalimat akhir.
4.7.2. Hasil Kuantitatif
Kalimat terakhir dibandingkan dengan kebenaran dasar untuk menghitung skor WER sebagai hasil kuantitatif. Untuk CSL, kami membagi kumpulan data menjadi 80 persen untuk data pelatihan dan 20 persen untuk data pengujian. Seperti yang ditunjukkan pada Tabel 5, model multi-fitur (STMF) yang kami usulkan menggunakan fitur full-frame dan keypoint dapat mencapai hasil yang lebih baik dan menurunkan WER menjadi 0,8 dibandingkan dengan model yang hanya menggunakan fitur full-frame [23]. Hasil terbaik kami diperoleh dengan model multi-fitur yang diusulkan menggunakan mekanisme perhatian (STAMF), yang mencapai 0,7 untuk WER. Lapisan perhatian masih sedikit meningkatkan hasil meskipun dataset CSL tidak memiliki bingkai yang rusak. Ini membuktikan bahwa lapisan perhatian berdampak pada model. Model multi-fitur yang diusulkan itu sendiri lebih unggul daripada metode canggih dan lapisan perhatian berkontribusi terhadap penurunan skor WER pada dataset CSL. Key point pada CSL memberikan dampak yang signifikan karena dapat memberikan informasi yang efektif dibandingkan dengan metode multi-fitur lainnya [17] yang menggunakan tangan, wajah, dan pose tubuh.
Untuk dataset RWTH-PHOENIX, kami menggunakan konfigurasi buatan untuk membagi data pelatihan dan pengujian. Dataset dibagi menjadi 5672 video sampel untuk pelatihan, 540 video sampel untuk validasi diri, dan 629 video sampel untuk pengujian. Seperti yang ditunjukkan pada Tabel 6, hasil model multi-fitur (STMF) yang kami usulkan menggunakan fitur full-frame dan keypoint memiliki 24 persen WER, dan hasil terbaik kami adalah 20,5 persen , diperoleh dari model yang diusulkan menggunakan modul perhatian (STAMF) dalam hasil pelatihan. Hasil tes terbaik kedua dibandingkan dengan [17] karena mereka menggunakan lebih banyak fitur sebagai masukan. Namun, modul perhatian terbukti memberikan kontribusi yang signifikan terhadap penurunan skor WER untuk dataset RWTHPHOENIX. Berbeda dari hasil kami untuk dataset CSL, model yang kami usulkan dengan multi-aliran tidak mencapai hasil yang optimal. Ini karena set data RWTH-PHOENIX memiliki banyak frame yang rusak; mereka memiliki bagian yang buram, terutama di area tangan. Frame ini memberikan informasi keypoint yang tidak konsisten karena posisi keypoint yang hilang atau salah sehingga membuat model menjadi kurang optimal. Masalah ini ditangani dengan menambahkan lapisan perhatian ke model multi-fitur yang kami usulkan, yang membantu memilih informasi yang benar dan menghasilkan peningkatan yang signifikan dibandingkan dengan model multi-fitur yang diusulkan tanpa perhatian.
Tabel 5. Perbandingan Kinerja WER pada dataset CSL.
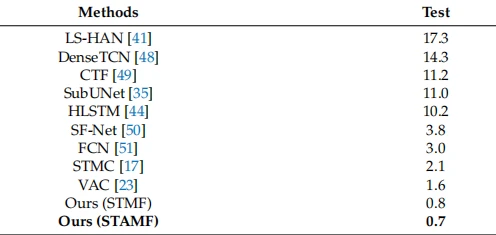
Tabel 6. Perbandingan Kinerja WER pada dataset RWTH-PHOENIX.

4.7.3. Hasil Kualitatif
Kami juga melakukan evaluasi kualitatif terhadap model kami, menggunakan visualisasi hasil pengenalan. Gambar 8 menunjukkan rincian evaluasi kualitatif kami menggunakan tiga sampel kalimat. Kalimat pertama terdiri dari 10 kata dan jumlah frame 220. Kalimat kedua terdiri dari 12 kata dan jumlah frame 168. Kalimat ketiga terdiri dari 9 kata dan jumlah frame 135.
Hasil sampel menunjukkan bahwa beberapa glos tidak diprediksi dengan benar oleh model, dan kami menandainya dengan tanda merah. Namun, itu masih bisa memprediksi sebagian besar kata yang benar. Jumlah kesalahan terbesar ada di kalimat pertama, yang memiliki nomor bingkai terpanjang. Pada kalimat ini, awal kalimat lebih banyak kesalahan, dikarenakan beberapa gestur untuk kata awal hanya sedikit berbeda sehingga sulit untuk membedakan batasannya. Namun, model yang diusulkan dengan multi-fitur dan perhatian (STAMF) dapat mengidentifikasi lebih banyak kata, tetapi salah label. Selain itu, konfigurasi model dengan perhatian mencapai hasil pengenalan yang lebih baik untuk dua sampel lainnya, dibandingkan dengan model yang diusulkan tanpa perhatian.

Gambar 8. Evaluasi kualitatif hasil pengenalan menggunakan konfigurasi yang berbeda dari dataset RWTH-PHOENIX [33,39]. Glos yang diprediksi salah ditandai dengan warna merah.
5. Kesimpulan
Dalam makalah ini, kami menyajikan novel spatiotemporal attention multi-feature (STAMF) untuk CSLR, yang bertujuan untuk mempelajari korelasi spasial-temporal dan informasi penting dari urutan fitur visual dan fitur keypoint dalam pendekatan end-to-end. Dalam kerangka kerja kami, modul spasial dikembangkan dengan fitur full-frame dari data RGB dan titik kunci dari titik kunci badan, termasuk tangan sebagai multi-fitur. Kombinasi ini digunakan sebagai input fitur multi-aliran memberikan kinerja yang unggul dibandingkan dengan pendekatan state-of-the-art yang hanya menggunakan full-frame atau dibandingkan dengan metode Gambar 8. Evaluasi kualitatif hasil pengenalan menggunakan konfigurasi RWTH yang berbeda -Dataset PHOENIX [33,39]. Glos yang diprediksi salah ditandai dengan warna merah. 5. Kesimpulan Dalam makalah ini, kami menyajikan novel spatiotemporal attention multi-feature (STAMF) untuk CSLR, yang bertujuan untuk mempelajari korelasi spasial-temporal dan informasi penting dari urutan fitur visual dan fitur titik kunci pada akhir-ke- pendekatan akhir. Dalam kerangka kerja kami, modul spasial dikembangkan dengan fitur full-frame dari data RGB dan titik kunci dari titik kunci badan, termasuk tangan sebagai multi-fitur. Kombinasi ini digunakan sebagai input fitur multi-aliran memberikan kinerja yang unggul dibandingkan dengan pendekatan canggih yang hanya menggunakan full-frame atau dibandingkan dengan metode yang menggunakan kombinasi multi-fitur lainnya, terutama untuk dataset CSL. Kemudian, kami mengusulkan modul temporal yang terdiri dari pengumpulan temporal dan perhatian temporal untuk menangkap informasi penting dalam domain temporal. Penambahan perhatian temporal yang terlambat mampu memperoleh fitur penting dari urutan yang memiliki informasi yang salah dan memberikan peningkatan yang signifikan dibandingkan dengan model multi-fitur yang kami usulkan. Ini juga membantu pembelajaran sekuensial untuk belajar lebih baik dan meningkatkan kinerja seperti pada percobaan dataset CSL. Eksperimen ekstensif pada kumpulan data yang umum digunakan menunjukkan keunggulan model yang kami usulkan dibandingkan model canggih dengan skor WER menurun lebih dari 50 persen untuk kumpulan data CSL dan menurun sebesar 5 persen untuk kumpulan data RWTH-PHOENIX. Di masa depan, kami berencana menerapkan teknik pembelajaran transfer dengan model kami saat ini serta menerapkan pekerjaan kami yang sedang berlangsung di industri nyata.
Referensi
1. Dreuw, P.; Rybach, D.; Deselaers, T.; Zahedi, M.; Ney, H. Teknik Pengenalan Pidato untuk Sistem Pengenalan Bahasa Isyarat. Dalam Prosiding INTERSPEECH 2007, Konferensi Tahunan ke-8 Asosiasi Komunikasi Pidato Internasional, Antwerpen, Belgia, 27–31 Agustus 2007; hlm. 2513–2516.
2. Ong, SCW; Ranganath, S. Analisis bahasa isyarat otomatis: Survei dan Masa Depan Melampaui Makna Leksikal. Trans IEEE. Pola Anal. Mesin Intell. 2005, 27, 873–891. [Referensi Silang] [PubMed]
3. Vogler, C.; Metaxas, D. Kerangka Kerja untuk Mengenali Aspek Simultan Bahasa Isyarat Amerika. Komputer. Vis. Pemahaman Gambar. 2001, 81, 358–384. [Referensi Silang]
4. Bowden, R.; Windridge, D.; Kadir, T.; Zisserman, A.; Brady, M. Sebuah Vektor Fitur Linguistik untuk Interpretasi Visual Bahasa Isyarat. Dalam Prosiding Konferensi Eropa tentang Visi Komputer (ECCV), Praha, Republik Ceko, 11–14 Mei 2004; hlm. 390–401.
5. Kasukurthi, N.; Rokad, B.; Bidani, S.; Dennisan, DA Pengenalan Alfabet Bahasa Isyarat Amerika menggunakan Deep Learning. arXiv 2019, arXiv:1905.05487.
6. Koller, O.; Zargaran, S.; Ney, H.; Bowden, R. Deep Sign: Mengaktifkan Pengenalan Bahasa Isyarat Berkesinambungan Statistik yang Kuat melalui Hybrid CNN-HMMs. Int. J.Komput. Vis. 2018, 126, 1311–1325. [Referensi Silang]
7. Pu, J.; Zhou, W.; Li, H. Dilated Convolutional Network dengan Optimasi Iteratif untuk Pengenalan Bahasa Isyarat Berkelanjutan. Dalam Prosiding Konferensi Bersama Internasional ke-27 tentang Kecerdasan Buatan, Stockholm, Swedia, 13–19 Juli 2018; hlm.885–891.
8. Pu, J.; Zhou, W.; Li, H. Jaringan Penyelarasan Iteratif untuk Pengenalan Bahasa Isyarat Berkelanjutan. Dalam Prosiding Konferensi Masyarakat Komputer IEEE tentang Visi Komputer dan Pengenalan Pola, Long Beach, CA, AS, 15–20 Juni 2019; hlm. 4160–4169.
9. Kumar, N. Pelacakan Wajah dan Tangan Manusia Berbasis Lintasan Gerak untuk Pengenalan Bahasa Isyarat. Dalam Prosiding Konferensi Internasional 2017 4th IEEE Uttar Pradesh Section on Electrical, Computer and Electronics, Mathura, India, 26–28 Oktober 2017; hlm. 211–216.
10. Bhuyan, MK; Ghoah, D.; Bora, PK Framework Pengenalan Gerakan Tangan dengan Aplikasi Bahasa Isyarat. Dalam Prosiding Konferensi India Tahunan 2006, INDICON, New Delhi, India, 15–17 September 2006; hlm. 1–6.
11. Das,SP; Talukdar, AK; Sarma, KK Pengenalan Bahasa Isyarat Menggunakan Ekspresi Wajah. Dalam Prosiding Ilmu Komputer Procedia, Kerala, India, 10–13 Agustus 2015; hlm. 210–216.
12. Rastgoo, R.; Kiani, K.; Escalera, S.; Sabokrou, M. Produksi Bahasa Isyarat: Sebuah Tinjauan. Dalam Prosiding Konferensi IEEE/CVF 2021 tentang Visi Komputer dan Lokakarya Pengenalan Pola (CVPRW), Nashville, TN, AS, 19–25 Juni 2021; hlm. 3446–3456.
13. Dong, S.; Wang, P.; Abbas, K. Survei Deep Learning dan Penerapannya. Komputer. Sains. Rev. 2021, 40, 100379. [Ref Silang]
14. Athitsos, V.; Neidle, C.; Sclaroff, S.; Nash, J.; Stefan, A.; Yuan, Q.; Thangali, A. Kumpulan Data Video Leksikon Bahasa Isyarat Amerika. Dalam Prosiding Konferensi Masyarakat Komputer IEEE 2008 tentang Visi Komputer dan Lokakarya Pengenalan Pola, Lokakarya CVPR, Anchorage, Alaska, 23-28 Juni 2008; hlm. 1–8.
15. Bungeroth, J.; Stein, D.; Dreuw, P.; Ney, H.; Morrissey, S.; Cara, A.; Zijl, LV Korpus Bahasa Isyarat ATIS. Dalam Prosiding Konferensi Internasional ke-6 tentang Sumber Daya dan Evaluasi Bahasa, LREC 2008, Marrakech, Maroko, 28–30 Mei 2008; hlm. 2943–2946.
16. Papastratis, I.; Chatzikonstantinou, C.; Konstantinidis, D.; Dimitropoulos, K.; Daras, P. Teknologi Kecerdasan Buatan untuk Bahasa Isyarat. Sensor 2021, 21, 5843. [CrossRef] [PubMed]
17. Zhou, H.; Zhou, W.; Zhou, Y.; Li, H. Jaringan Multi-isyarat Spasial-temporal untuk Pengenalan Bahasa Isyarat Berkelanjutan. Dalam Prosiding AAAI 2020—Konferensi AAAI Ketiga Puluh Empat tentang Kecerdasan Buatan, New York, NY, AS, 7–12 Februari 2020; hlm. 13009–13016.
18. Gündüz, C.; Polat, H. pengenalan bahasa isyarat Turki berdasarkan fusi data multistream. Turki J. Electr. Eng. Komputer. Sains. 2021, 29, 1171–1186. [Referensi Silang]
19. Bohacek, M.; Hruz, M. Sign Transformer Berbasis Pose untuk Pengenalan Bahasa Isyarat Tingkat Kata. Dalam Prosiding Konferensi Musim Dingin IEEE/CVF 2022 tentang Aplikasi Lokakarya Computer Vision, WACVW, Waikoloa, HI, USA, 4–8 Januari 2022; hlm. 182–191.
20. Vaswani, A. Perhatian Adalah Yang Anda Butuhkan. Dalam Prosiding Konferensi tentang Sistem Pemrosesan Informasi Neural, Long Beach, CA, USA, 4–9 Desember 2017; hlm. 1–11.
21. Zhou, M.; Ng, M.; Cai, Z.; Cheung, KC Jaringan Pengenalan Penuh Berbasis Perhatian Diri untuk Pengenalan Bahasa Isyarat Berkelanjutan. Depan. Artifisial Intell. Aplikasi 2020, 325, 2832–2839.
22. Camgoz, NC; Koller, O.; Hadfifield, S.; Bowden, R. Transformers Bahasa Isyarat: Pengenalan dan Terjemahan Bahasa Isyarat ujung ke ujung bersama. Dalam Prosiding IEEE Computer Society Conference on Computer Vision and Pattern Recognition, Seattle, WA, USA, 14-19 Juni 2020; hlm. 10020–10030.
23. Min, Y.; Hao, A.; Chai, X.; Chen, X. Kendala Penyelarasan Visual untuk Pengenalan Bahasa Isyarat Berkelanjutan. Dalam Prosiding Konferensi Internasional IEEE tentang Visi Komputer (ICCV), Montreal, BC, Kanada, 10–17 Oktober 2021; hlm. 11542–11551.
24. Guo, D.; Zhou, W.; Wang, M.; Li, H. Pengenalan Bahasa Isyarat Berdasarkan HMM Adaptif dengan Augmentasi Data. Dalam Prosiding Konferensi Internasional IEEE tentang Pemrosesan Gambar (ICIP), Phoenix, AZ, AS, 25–28 September 2016; hlm. 2876–2880.
25. Huang, J.; Zhou, W.; Li, H.; Li, W. Pengenalan Bahasa Isyarat Menggunakan Jaringan Syaraf Konvolusional 3D. Dalam Prosiding IEEE International Conference on Multimedia and Expo (ICME), Turin, Italia, 29 Juni–3 Juli 2015; hlm. 1–6.
26. Guo, D.; Zhou, W.; Li, H.; Wang, M. Penggabungan awal-akhir online berdasarkan HMM adaptif untuk pengenalan bahasa isyarat. ACM Trans. Multimed. Komputer. Komunal. Aplikasi 2017, 14, 1–18. [Referensi Silang]
27. Al-hammadi, M.; Muhammad, G.; Anggota, S. Pengenalan Gerakan Tangan untuk Bahasa Isyarat Menggunakan 3DCNN. Akses IEEE 2020, 8, 79491–79509. [Referensi Silang]
28. Reza, H.; Joze, V. MS-ASL: Kumpulan Data Berskala Besar dan Tolok Ukur untuk Memahami Bahasa Isyarat Amerika. arXiv 2019, arXiv:1812.01053.
29. Li, D.; Opazo, CR; Yu, X.; Li, H. Pengenalan Bahasa Isyarat Mendalam Tingkat Kata dari Video: Dataset Skala Besar Baru dan Perbandingan Metode. Dalam Prosiding Konferensi Musim Dingin IEEE 2020 tentang Aplikasi Computer Vision, WACV, Snowmass Village, CO, USA, 1–5 Maret 2020; hlm. 1448–1458.
30. Pu, J.; Zhou, W.; Li, H. Pengenalan Bahasa Isyarat dengan Fitur Multi-modal. Dalam Prosiding Konferensi Lingkar Pasifik tentang Multimedia, Xi'an, Tiongkok, 15–16 September 2016; hlm. 252–261.
31. Jiang, S.; Matahari, B.; Wang, L.; Bai, Y.; Li, K.; Fu, Y. Skeleton Aware Pengenalan Bahasa Isyarat Multi-modal. Dalam Prosiding Konferensi Masyarakat Komputer IEEE tentang Visi Komputer dan Lokakarya Pengenalan Pola, Nashville, TN, AS, 19–25 Juni 2021; hlm. 3408–3418.
32. Sidig, AAI; Luqman, H.; Mahmud, S.; Mohandes, M. KArSL: Basis Data Bahasa Isyarat Arab. ACM Trans. Sumber Daya Rendah Asia. Lang. Inf. Memproses 2021, 20, 1–19. [Referensi Silang]
33. Koller, O.; Forster, J.; Ney, H. Pengenalan bahasa isyarat berkelanjutan: Menuju sistem pengenalan statistik kosakata besar yang menangani banyak penanda tangan. Komputer. Vis. Pemahaman Gambar. 2015, 141, 108–125. [Referensi Silang]
34. Koller, O.; Camgoz, NC; Ney, H. Weakly Supervised Learning dengan Multi-Stream CNN-LSTM-HMMs untuk Menemukan Paralelisme Berurutan dalam Video Bahasa Isyarat. Trans IEEE. Pola Anal. Mesin Intell. 2020, 42, 2306–2320. [Referensi Silang] [PubMed]
35. Camgoz, NC; Hadfifield, S.; Koller, O.; Bowden, R. SubUNets: Bentuk Tangan Ujung-ke-Ujung dan Pengenalan Bahasa Isyarat Berkelanjutan. Dalam Prosiding Konferensi Internasional IEEE 2017 tentang Visi Komputer (ICCV), Venesia, Italia, 22–29 Oktober 2017; hlm. 3075–3084.
36. Dong, C.; Loi, CC; Dia, K.; Tang, X. Image Super-Resolution Menggunakan Deep Convolutional Networks. Trans IEEE. Pola Anal. Mesin Intell. 2014, 38, 295–307. [Referensi Silang] [PubMed]
37. Bressem, KK; Adams, LC; Erxleben, C.; Hamm, B.; Niehues, SM; Vahldiek, JL Membandingkan arsitektur deep learning yang berbeda untuk klasifikasi radiografi dada. Sains. Rep. 2020, 10, 13590. [Referensi Silang]
38. Matahari, K.; Xiao, B.; Liu, D.; Wang, J. Pembelajaran Representasi Resolusi Tinggi Mendalam untuk Estimasi Pose Manusia. Dalam Prosiding Konferensi Masyarakat Komputer IEEE tentang Visi Komputer dan Pengenalan Pola, Long Beach, CA, AS, 15–20 Juni 2019; hlm.5686–5696.
39. Koller, O.; Zargaran, S.; Ney, H. Re-Sign: Re-Aligned End-to-End Sequence Modeling dengan Deep Recurrent CNN-HMMs. Dalam Prosiding Konferensi IEEE 2017 tentang Computer Vision and Pattern Recognition (CVPR), Honululu, HI, USA, 21–26 Juli 2017; hlm. 3416–3424.
40. Zhou, H.; Zhou, W.; Li, H. Pengodean label semu dinamis untuk pengenalan bahasa isyarat berkelanjutan. Dalam Prosiding 2019 IEEE International Conference on Multimedia and Expo (ICME), Shanghai, Tiongkok, 18–21 Juli 2019; hlm. 1282–1287.
41. Xiao, Q.; Chang, X.; Zhang, X.; Liu, X. Pengenalan Bahasa Isyarat Berbasis Video tanpa Segmentasi Temporal. Dalam Prosiding Konferensi AAAI Ketiga Puluh Dua tentang Kecerdasan Buatan, New Orleans, LA, AS, 2–7 Februari 2018; hlm. 2257–2264.
42. Makam, A.; Fernández, S.; Gomez, F.; Schmidhuber, J. Klasifikasi Temporal Koneksionis: Memberi Label Data Urutan Tidak Tersegmentasi dengan Jaringan Syaraf Berulang. Dalam Prosiding ICML '06: Prosiding konferensi internasional ke-23 tentang Pembelajaran Mesin, Pittsburgh, PA, AS, 25–29 Juni 2006; hlm. 369–376.
43. Makam, A.; Liwicki, M.; Fernández, S.; Bertolami, R.; Bunke, H.; Schmidhuber, J. Sistem Koneksionis Baru untuk Pengenalan Tulisan Tangan Tanpa Kendala. Trans IEEE. Pola Anal. Mesin Intell. 2009, 31, 855–868. [Referensi Silang]
44. Guo, D.; Zhou, W.; Li, H.; Wang, M. Hierarchical LSTM untuk Terjemahan Bahasa Isyarat. Dalam Prosiding Konferensi AAAI tentang Kecerdasan Buatan, New Orleans, LA, AS, 2–7 Februari 2018; hlm. 6845–6852.
45. Rahman, MM; Watanobe, Y.; Nakamura, K. Model Bahasa LSTM Dua Arah untuk Evaluasi dan Perbaikan Kode. Simetri 2021, 13, 247. [Ref Silang]
46. Hu, W.; Cai, M.; Chen, K.; Ding, H.; Sun, L.; Liang, S.; Mo, X.; Huo, Q. Pelatihan Diskriminatif Urutan untuk Pengenalan Tulisan Tangan Offline oleh CTC Interpolasi dan Fungsi Tujuan MMI Bebas Kisi. Dalam Prosiding Konferensi Internasional tentang Analisis dan Pengakuan Dokumen, ICDAR, Kyoto, Jepang, 9–15 November 2017; Volume 1, hlm. 61–66.
47. Yoshimura, T.; Hayashi, T.; Takeda, K.; Watanabe, S. Pengenalan Suara Otomatis End-to-End Terintegrasi dengan Deteksi Aktivitas Suara Berbasis CTC. Dalam Prosiding ICASSP, IEEE International Conference on Acoustics, Speech and Signal Processing, Barcelona, Spanyol, 4–8 Mei 2020; hlm. 6999–7003.
48. Guo, D.; Wang, S.; Tian, Q.; Wang, M. Jaringan Konvolusi Temporal Padat untuk Terjemahan Bahasa Isyarat. Dalam Prosiding Konferensi Bersama Internasional ke-28 tentang Kecerdasan Buatan (IJCAI-19), Macao, Tiongkok, 10–16 Agustus 2017; hlm. 744–750.
49. Wang, S.; Guo, D.; Zhou, W.; Zha, Z.; Wang, M. Connectionist Temporal Fusion untuk Terjemahan Bahasa Isyarat. Dalam Prosiding Konferensi Internasional ACM ke-26 tentang Multimedia, Seoul, Korea, 22–26 Oktober 2018; hlm. 1483–1491.
50. Yang, Z.; Shi, Z. SF-Net: Jaringan Fitur Terstruktur untuk Pengenalan Bahasa Isyarat Berkelanjutan. arXiv 2019, arXiv:1908.01341.
51. Cheng, Kuala Lumpur; Yang, Z.; Chen, Q.; Tai, Y. Jaringan Sepenuhnya Konvolusional Untuk Pengenalan Bahasa Isyarat Berkelanjutan. Dalam Prosiding Konferensi Eropa tentang Computer Vision, Glasgow, UK, 23–28 Agustus 2020; hlm. 697–714.
52. Koller, O.; Ney, H.; Bowden, R. Deep Hand: Cara Melatih CNN dengan 1 Juta Gambar Tangan Saat Data Anda Berkelanjutan dan Berlabel Lemah. Dalam Prosiding Konferensi IEEE 2016 tentang Visi Komputer dan Pengenalan Pola (CVPR), Las Vegas, NV, AS, 27–30 Juni 2016; hlm. 3793–3802.
53. Slimane, Masalah Konteks FB: Perhatian Diri untuk Pengenalan Bahasa Isyarat. arXiv 2021, arXiv:2101.04632.
54. Niu, Z.; Mak, B. Pelabelan Berbutir Halus Stochastic dari Multi-state Sign Glosses untuk Pengenalan Bahasa Isyarat Berkelanjutan. Dalam Prosiding Konferensi Eropa tentang Computer Vision, Glasgow, UK, 23–28 Agustus 2020; hlm. 1–16.
55. Cui, R.; Liu, H.; Zhang, C. Kerangka Syaraf Mendalam untuk Pengenalan Bahasa Isyarat Berkelanjutan dengan Pelatihan Iteratif. Trans IEEE. Multimed. 2019, 21, 1880–1891. [Referensi Silang]
56. Pu, J.; Zhou, W.; Hu, H.; Li, H. Meningkatkan Pengenalan Bahasa Isyarat Berkelanjutan melalui Augmentasi Lintas Modalitas. Dalam Prosiding Konferensi Internasional ACM ke-28 tentang Multimedia, Seattle, WA, AS, 12–16 Oktober 2020; hlm. 1497–1505.